

서강대 이혁준 교수팀, 음성·언어 모델 압축 기술 'EMNLP' 채택
등록 2026.10.06 11:30:46


EMNLP 2026 파인딩스에 연구 성과 게재
토큰 수 줄이면서 주요 정보 손실은 막아
[서울=뉴시스] 설명. (사진= 제공) 2026.10.06. [email protected] *재판매 및 DB 금지
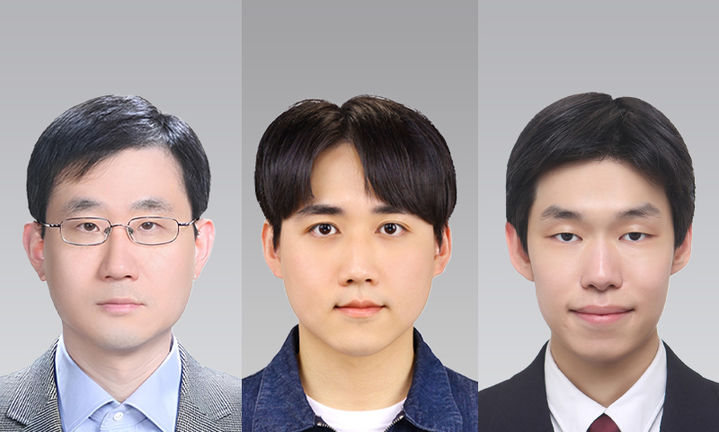
6일 서강대에 따르면 이번 연구는 서강대 지능형 컴퓨터 아키텍처 및 임베디드 컴퓨팅 연구실(ECL) 소속 정재한 석사과정생(제1저자)·이태한 박사과정생이 참여했으며, 이 교수가 교신저자를 맡았다.
연구팀은 음성을 수많은 작은 단위의 오디오 토큰 시퀀스로 변환해 처리하는 최근 오디오-언어 모델의 높은 추론 비용 문제 해결에 나섰다.
먼저 모델 내부를 분석한 결과, 오디오 인코더에서는 토큰 간 중복성이 높고, 프로젝터를 거친 뒤에는 표현이 더 분산된다는 서로 다른 특성을 확인했다.
이를 바탕으로 연구팀은 램프(Regime-Aware Merge–Prune)를 제안했다. 램프는 추가 학습 없이 적용할 수 있으며, 어텐션 맵(Attention Map)을 사용하지 않아 플래시 어텐션(Flash Attention) 기반 추론 환경과도 호환된다.
램프의 핵심은 각 단계에 나타나는 표현 특성에 맞춰 서로 다른 압축 전략을 적용하는 데 있다.
인코더에서는 유사 정보를 가진 토큰을 병합해 시퀀스 길이를 줄이고, 프로젝터 이후에는 음성인식에 중요한 정보를 포함한 토큰을 선택적으로 유지해 정보 손실을 줄인다.
이를 통해 모델 구조나 학습 과정을 크게 바꾸지 않으면서도 처리해야 하는 토큰 수를 줄여, 추론 과정의 연산 효율을 대폭 높였다.
연구팀은 오디오-플라밍고-3(Audio-Flamingo-3)와 큐원2.5-옴니-7B(Qwen2.5-Omni-7B)를 대상으로 7개 음성인식 벤치마크에서 성능을 평가했다.
특히 Audio-Flamingo-3에서 오디오 토큰을 40%만 유지하는 조건에서 평균 단어 오류율(WER) 증가 폭을 비교 기법(4.26배)보다 낮은 2.36배로 방어했으며, 기본 모델 대비 첫 토큰 생성 시간(TTFT)을 24.8% 단축했다.
이번 연구는 오디오-언어 모델의 단계별 표현 특성에 맞는 토큰 압축 방식을 통해 음성인식 성능 저하를 줄이면서 추론 효율을 향상했다는 점에서 의미가 있다.
◎공감언론 뉴시스 yein020528
Copyright © NEWSIS.COM, 무단 전재 및 재배포 금지